KI-gestützte Dokumentenanalyse für Unternehmen
Die BECONEX AI Suite erweitert Ihre Workflows zur Dokumentenverarbeitung um drei KI-gestützte Funktionen. Diese werden jeweils von einem lokalen Sprachmodell innerhalb Ihres Netzwerks betrieben.
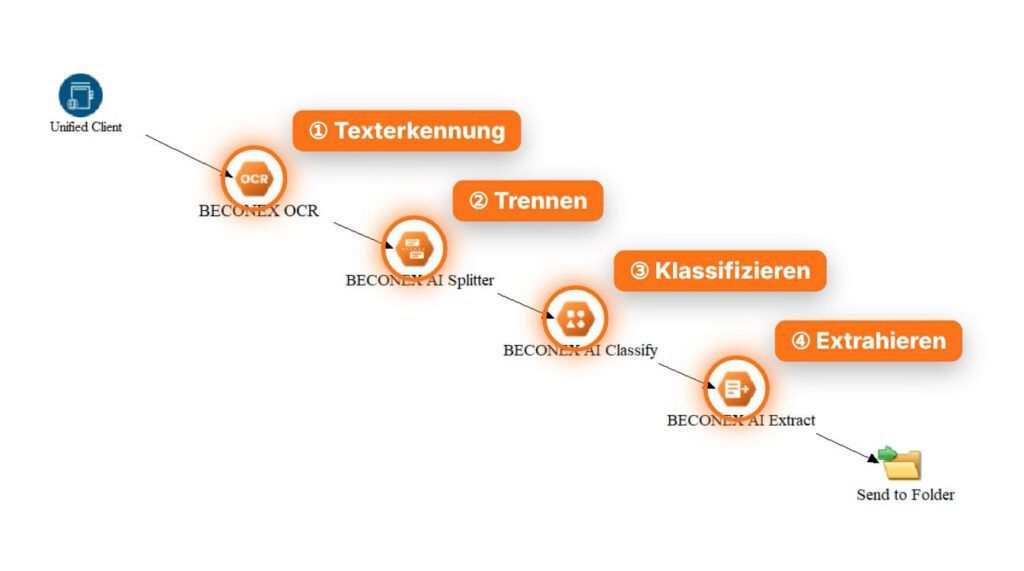
„Trennen“ unterteilt gescannte Stapel in einzelne Dokumente, „Klassifizieren“ weist jedem Dokument eine Klasse zu und „Extrahieren“ liest die von Ihnen definierten Felder aus.
Optimieren Sie Ihre Arbeitsprozesse durch KI-gestützte Dokumentenanalyse.
Drei Verarbeitungsschritte, eine KI-Kette
Trennen
Ermittelt in einem Stapel gescannter Dokumente, wo ein Dokument endet und das nächste beginnt. Jedes gefundene Dokument wird zu einem eigenständigen Element im Arbeitsablauf.
Trennblätter zwischen Dokumenten sind nicht mehr erforderlich.
Klassifizieren
Weist jedem Dokument eine Klasse aus einer vordefinierten Liste zu, versehen mit einem Konfidenzwert.
Für die Stapelverarbeitung muss „Trennen“ vor „Klassifizieren“ erfolgen.
Dokumente werden automatisch an den richtigen Workflow weitergeleitet.
Extrahieren
Liest die Felder für die Klasse (oder alle Felder, falls keine Klasse angegeben ist) aus und gibt für jedes Feld einen Wert sowie einen Konfidenzwert zurück. Das Feld bleibt leer, wenn kein Wert gefunden wird.
Die extrahierten Daten werden strukturiert und standardisiert für das Endsystem bereitgestellt.
Konfiguration eines Workflows zur Dokumentenanalyse
Die BECONEX AI Suite läuft auf der Tungsten (Kofax) AutoStore-Plattform. Sie konfigurieren jeden Schritt in einem jeweils zugehörigen Dialog – genau wie bei jeder anderen Prozesskomponente.
Die GPU-Serveradresse, das Sprachmodell, Zeitlimits sowie die zulässige Anzahl an Wiederholungsversuchen.
- Testen Sie die Leistung jedes einzelnen Schritts sowie die gesamte Prozesskette anhand von Beispielen aus Ihren eigenen Dokumenten, bevor Sie in den Produktivbetrieb gehen.
- Änderungen am Modell beeinflussen, wie sicher es in seinen Aussagen wirkt; überprüfen Sie daher nach jedem Modellwechsel sämtliche Schwellenwerte erneut.
- Benennen Sie die Ausgabevariablen nicht um, da nachgelagerte Prozessschritte von diesen abhängig sind.
Standard-AutoStore-Schritte können die Werte für weitere Aufgaben der Dokumentenverarbeitung nutzen. Dazu gehören beispielsweise:
- Das Erstellen von Ordnerpfaden und Dateinamen,
- das Schreiben von Indexdaten,
- die Weiterleitung von Dokumenten und Daten an SAP oder ein anderes Dokumentenmanagementsystem usw.
Stapeltrennung
Legen Sie einen Konfidenzschwellenwert fest. Bestimmen Sie, wann die vorgeschlagene Trennung einem Prüfer zur Kontrolle vorgelegt werden soll, bevor die Stapelverarbeitung fortgesetzt wird – entweder jedes Mal oder nur in Fällen von Unsicherheit.
Alle Dokumente im Stapel bleiben so lange „geparkt“, bis die Prüfung abgeschlossen ist.
- Jedes Dokument als eigenes Element,
- Entscheidung pro Seite (gehört zum vorangegangenen Dokument oder beginnt ein neues),
- Konfidenzwert für jede Entscheidung
Dokumentenklassifizierung
Definieren Sie Ihre Liste der Dokumentenklassen sowie den Konfidenzschwellenwert, unterhalb dessen ein Dokument zur manuellen Überprüfung weitergeleitet wird.
Der geeignete Schwellenwert hängt vom Modell und vom Eingabeweg (Scan oder digitales PDF) ab. Überprüfen Sie den Wert erneut, falls Sie eines dieser beiden Elemente ändern.
- Die identifizierte Klasse sowie ein Konfidenzwert.
- Im Zweifelsfall liefert das Modell eine Datei, die die Begründung für die Entscheidung erläutert, und die Dokumente werden in einen Prüfkorb verschoben.
Datenextraktion
Konfigurieren Sie, welche Felder ausgelesen werden sollen, und legen Sie fest, ob die Klasse von der „Klassifizieren“-Komponente übernommen wird.
Um bessere Ergebnisse zu erzielen, definieren Sie nur Felder, die tatsächlich im Dokument vorkommen.
Eindeutige Feldnamen führen zu klareren Ergebnissen.
- Der für jedes konfigurierte Feld ermittelte Wert als Workflow-Variable,
- Der Konfidenzwert des Feldes.
Häufig gestellte Fragen
Ja. Jede Komponente kann bei der Installation ausgewählt werden und eigenständig funktionieren. Für die Stapelklassifizierung muss „Trennen“ vor „Klassifizieren“ ausgeführt werden. „Extrahieren“ verwendet – sofern vorhanden – die durch „Klassifizieren“ ermittelte Klasse; andernfalls werden alle konfigurierten Felder ausgelesen.
Unsichere Ergebnisse werden einem menschlichen Prüfer vorgelegt. Im Zuge der Prüfung können die Ergebnisse bestätigt oder angepasst werden. Stapel und Dokumente bleiben so lange in Wartestellung, bis sie vom Prüfer freigegeben wurden. Erst danach werden sie an die nachfolgenden Schritte im Arbeitsablauf weitergeleitet.
Jedes Feld steht als Workflow-Variable zur Verfügung. So kann Ihr AutoStore-Prozess Dateien benennen, Ordnerpfade erstellen, Indexdaten schreiben sowie Dokumente und Daten an SAP oder andere Systeme weiterleiten.