Comprensión documental para empresas
La BECONEX AI Suite incorpora tres funcionalidades basadas en inteligencia artificial al procesamiento de documentos. Cada una de ellas se ejecuta mediante un modelo de lenguaje local dentro de su propia red.
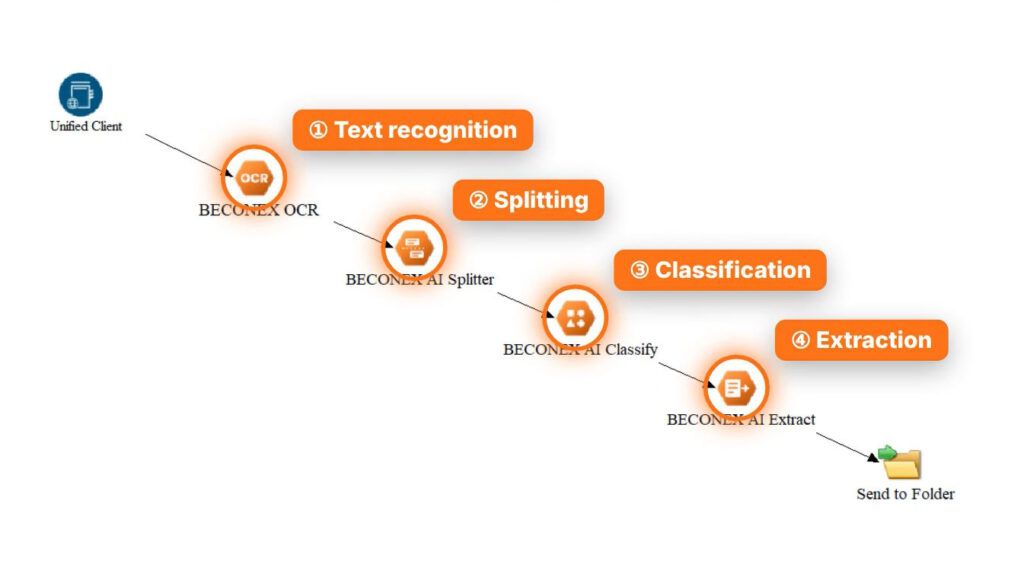
«Dividir» separa los lotes escaneados en documentos individuales; «Clasificar» asigna una clase a cada documento; y «Extraer» lee los campos que usted defina. Optimice sus operaciones mediante la comprensión documental basada en IA.
Tres etapas de procesamiento, una cadena de IA
Dividir
Detecta dónde termina un documento y dónde comienza el siguiente en un lote escaneado. Cada documento detectado se convierte en un elemento independiente dentro del flujo de trabajo.
Clasificar
Asigna a cada documento una clase a partir de una lista predefinida, junto con un valor de confianza. Para el procesamiento por lotes, la operación «Dividir» debe realizarse antes de la operación «Clasificar».
Extraer
Lee los campos de la clase (o todos los campos si no se especifica ninguna clase) y devuelve un valor y un nivel de confianza para cada campo. Si no se encuentra ningún valor, el resultado queda vacío.
Este componente también se ejecuta de forma local.
Cómo configurar un proceso de comprensión documental
La BECONEX AI Suite funciona sobre la plataforma Tungsten (Kofax) AutoStore. Cada paso se configura en su cuadro de diálogo específico, al igual que cualquier otro componente de proceso.
La dirección del servidor GPU, el modelo de lenguaje, los límites de tiempo y los reintentos permitidos.
- Antes de pasar a producción, pruebe el rendimiento de cada paso y de toda la cadena, de principio a fin, utilizando un lote de muestra de sus propios documentos.
- Cambiar el modelo afecta al grado de seguridad con el que este se expresa; por ello, vuelva a revisar todos los umbrales tras cualquier modificación del modelo.
- No cambie el nombre de las variables de salida, ya que los pasos posteriores del flujo de trabajo dependen de ellas.
Los pasos estándar de AutoStore pueden utilizar estos valores para tareas adicionales de gestión documental. Entre ellas se incluyen:
- La creación de carpetas y nombres de archivo,
- El registro de datos de indexación,
- El envío de documentos y datos a SAP o a otro sistema de gestión documental, etc.
División de lotes
Establezca un umbral de confianza y decida cuándo se presenta la separación propuesta a un revisor antes de que el lote continúe: siempre, o solo en caso de incertidumbre.
Todos los documentos del lote permanecen en espera hasta que se complete la revisión.
- Cada documento como un elemento independiente,
- Decisión por página (si pertenece al documento anterior o inicia uno nuevo),
- Valor de confianza para cada decisión
Clasificación de documentos
Defina la lista de clases de documentos y el umbral de confianza por debajo del cual un documento se envía a revisión.
El umbral adecuado depende del modelo y del formato de entrada (documento escaneado o PDF digital). Vuelva a revisarlo si modifica cualquiera de estos elementos.
- La clase identificada y un valor de confianza.
- En caso de incertidumbre, el modelo genera un archivo que explica el razonamiento detrás de la decisión, y los documentos se envían a una bandeja de revisión.
Extracción de datos
Configure los campos que se deben leer y determine si la clase debe obtenerse a partir del componente de clasificación.
Para obtener mejores resultados, defina únicamente los campos que realmente aparecen en el documento.
Nombrar los campos claramente permite obtener resultados más precisos.
- El valor detectado para cada campo configurado, como variable de flujo de trabajo;
- El nivel de confianza del campo.
Preguntas frecuentes
Sí. Cada componente puede seleccionarse durante la instalación y funcionar de forma independiente.
Para la clasificación por lotes, el componente «Dividir» debe preceder al componente «Clasificar». El componente «Extraer» utiliza la clase obtenida mediante «Clasificar» cuando esta está disponible; de lo contrario, lee todos los campos configurados.
Los resultados inciertos se remiten a un revisor humano. Durante la revisión, dichos resultados pueden confirmarse o corregirse. Los lotes y documentos permanecen en espera hasta que el revisor los aprueba. Solo entonces son enviados a las etapas siguientes del flujo de trabajo.
Cada campo está disponible como variable de flujo de trabajo, de modo que su proceso AutoStore puede asignar nombres a los archivos, crear rutas de carpetas, escribir datos de indexación y dirigir documentos y datos hacia SAP u otros sistemas.